第2章
エンジン:言語モデルはどう動くのか
このページの内容
本書に出てくるシステムは、最も素朴なチャットボットから、協調して動くエージェントのフリートまで、どれも同じ構成要素を中心に作られています。大規模言語モデルです。中身について何も知らなくても、これを十分に使いこなすことはできます。ボンネットを一度も開けずに車を運転できるのと同じです。しかしエージェントを作るとなると、機械との関係が変わります。あなたはこの構成要素をループの中に置き、ツールを渡し、自分がその場にいない間に判断を下させようとしているのです。モデルがおかしな振る舞いをしたとき、「魔法だから」ではバグの範囲を絞り込めません。この章では、エージェントを作る人に最低限必要なメンタルモデルを、直感を先に、算数を超える数学は使わずに組み立てます。まず、モデルが根本的に何であるか(次のトークンを予測するもの)から始めます。続いて、その作業記憶(トークンとコンテキストウィンドウ)、書き方(サンプリングと、2回の実行で結果が違う理由)、モデルを誘導する方法(プロンプトの書き方)、テキストから現実のアクションへの橋(構造化出力と関数呼び出し)を取り上げ、最後に、モデルが決まって失敗するパターンを見ます。あとの章はこれらの考え方をすべて土台にしますが、どれ1つとして、あなたが何かを学習させる必要はありません。
次のトークンを予測するものとしてのLLM
次の文を完成させてください。「フランスの首都は___。」その言葉は、探そうと決める前から、すでにあなたの頭の中にありました。頭の中の地図帳を調べたり、候補となる都市を比べたり、地理について推論したりはしなかったはずです。一生分の読書が、パリをただ浮かび上がらせたのです。この反射を覚えておいてください。大規模言語モデルが何をしているのかについて、手に入る直感の中で最も正確なものだからです。モデルは、あなたがたったいまやったのと同じやり方でテキストを補完します。あなたと違うのは、それ以外のモードを持たないことです。
仕組みとして見ると、LLMは1つの関数です。ひとまとまりのテキストを受け取り、次に来うるすべてのトークンについて、それが次に来る確率を出力します。トークンとは、固定された語彙に含まれるテキストの断片です。多くは1つの単語ですが、単語の一部や句読点のこともあります。平均すると、英単語の4分の3くらいと考えてください。何かを書くときには、周囲のシステムがその順位付きのリストからトークンを1つ選んでテキストに追加し、長くなったテキストに対してもう一度モデルを実行します。1トークンずつ、何度も何度も、停止条件が発動するまで繰り返すのです。この方式は自己回帰生成と呼ばれます(新しいトークンはどれも、プロンプトか出力かを問わず、それより前のすべてを条件として生成されます)。そしてこの方式の性質の1つが、本書全体を通じてついて回ります。モデルは決して、答えの下書きを前もって用意しないということです。そのやり方のすべては、局所的な推測の繰り返しです。計画もアウトラインも、手元に取っておいてはいません(図2.1)。次の節ではトークンとモデルの作業記憶を本格的に検討し、その次の節では、トークンがどう選ばれるのか、そしてなぜその選択が毎回変わるのかを見ます。

推測の技能はどこに宿っているのでしょうか。モデルのパラメーター、別名重みの中です。重みとは、学習の間に決まる何十億もの数値で、入力テキストがニューラルネットワークの中をどう流れて、先ほどの確率を生み出すかを決めています。私が最も役に立つと思う見方は、次のとおりです。重みとは、モデルが学習中に読んだすべてのものに含まれるパターン(文法、事実、慣用句、コードのスタイル、論証の形)を、非可逆に圧縮して蒸留したものです。カギとなる言葉は「非可逆」です。モデルは読んだものの形を吸収しましたが、テキストそのものの保管庫は持っていません。だから、情報源を一字一句そのまま引用させたり、正確な数値を思い出させたりするのは賭けになります。その帰結には、この章の最後で立ち戻ります。
2つの活動は、はっきり区別しておく必要があります。両者を混同すると、こうしたシステムについての最もよくある誤解のいくつかが生まれるからです。学習は、重みのよい値を見つけるための、一度きりの、とてつもなく高価なプロセスです。モデルにテキストを見せて次のトークンを予測させ、間違えるたびに少しだけ修正します。それを、人間が1000回生まれ変わっても読みきれないほどの量のテキストにわたって繰り返すのです。学習はモデルの作り手が、専用のハードウェアで、あなたがそのモデルを目にするより前に行います。推論処理は、その後のあらゆる利用です。重みは凍結され、モデルはあなたの入力をそこに通すだけです。あなたがモデルを使って行うことは、チャットのやりとりも、エージェントのステップも、すべて推論処理です。ここから2つの帰結が導かれ、あなたはその両方を前提に設計しつづけることになります。第一に、モデルはあなたとの会話から学びません。あなたが何を打ち込んでも、重みは1つも変わりません。セッションの中で記憶のように感じられるものは、伸びていく実行記録が呼び出しのたびに読み直されているだけです。第二に、モデルに組み込まれた知識は学習データのカットオフ(それ以降のデータを見ていない時点)で止まっています。カットオフより後の出来事は単に存在せず、モデルはその欠落を確実に申告してはくれません。古くなった知識からも、新しい知識とまったく同じ自信をもって答えます。時間とともに変わる情報は、すべてプロンプトに入れて届けるか、ツールで取ってくる必要があります。
学習そのものはいくつかの段階に分かれています。その段階がわかると、知らずにいればつまずくはずの謎が解けます。最初の、最もコストのかかる段階である事前学習は、ウェブページ、書籍、コードといった広大で幅広いコーパスに対する、純粋な次トークン予測です。その産物がベースモデルです。流暢で、幅広い知識を持ち、そしてアシスタントとしては奇妙なほど役に立ちません。第1章では、そうしたモデルが質問に質問で答えることがあると軽く触れ、その理由はこの章で示すと約束しました。説明に必要な部品は、もうすべてあなたの手元にあります。読み進める前に、自分で組み立ててみてください。ベースモデルはテキストの続きを書くだけです。だから「このクエリを速くする3つの方法は?」と渡されると、もっともらしい続きを探します。そして、それが学んだ雑多なテキストの中では、1つの質問のあとに似たような質問が続くことがよくあります。さらなる質問のリストは、まったくありそうな返答なのです。ベースモデルは自分の仕事を完璧にこなしています。その仕事が、続きを書くことだというだけです。
事後学習(post-training)は、その生の「続きを書くもの」を、あなたが実際に出会ってきたアシスタントに変える、さらにあとの段階です。第1章の「モデルが指示を受け取れるようになった」という話は、これを指していました。ここでの目的にとって重要な手が2つあります。指示チューニング(instruction tuning)は、指示とよい応答を組にした厳選データでモデルを学習させ、質問にはさらなる質問ではなく答えを返すべきだと教えます。選好チューニング(preference tuning)は、人間(あるいは人間の判断をまねるよう学習したモデル)に競合する複数の答えを順位付けさせ、人間が好む種類の答え、つまり、より役に立ち、より正直で、より礼儀正しい答えに向けて重みを調整します。その最もよく知られた形はRLHF(人間のフィードバックによる強化学習)と呼ばれています。おなじみのアシスタントのペルソナは、事後学習から生まれます。そしてそれは、巨大な事前学習済みの中核に比べれば、比較的安価な塗装にすぎません。
事後学習で手に入らないものについても、同じくらいはっきりさせておきましょう。事後学習は新しい知識を加えませんし、でっち上げる傾向を取り除くこともありません。この主題についての広く視聴されたある講演が、これを印象的に言い表しています。事後学習はモデルが夢を見るのを止めるわけではない、その夢を、役に立つアシスタントの形をした夢に整えるのだ、というのです1 「夢を見る」という言い方はAndrej Karpathyによるもので、大規模言語モデルについての同氏の広く出回っている講演や論評(例:“Intro to Large Language Models”)に由来します。ここでは逐語的な引用ではなく、言い換えとして示しています。。礼儀作法の下で、エンジンは変わっていません。もっともらしい続きを目指して最適化する、次トークン予測器のままです。もっともらしさと真実には相関があります。その相関が存在するのは、学習用のテキストの大半が、現実の世界を描写する人間によって書かれたからです。しかし両者は、モデルが事実を持っていないまさにその場所で袂を分かちます。そしてその瞬間、仕組みは止まる代わりに、最ももっともらしく見える文字列を生み出します。まず流暢さ、正しさはその次。
エージェントを作る人にとって、ここから導かれることのうち、私があなたに何よりも覚えておいてほしいのは、モデルの知識が信頼性の異なる2つの場所にあるということです。パラメトリックな知識は重みの中にあります。カットオフの時点で凍結され、近似的で、出典を示すことができません。コンテキスト内の知識は、いまモデルの目の前にあるテキストです。新しく、中身を確かめることができ、検証もできます。モデルは、必要な事実がコンテキストにあるときのほうが、重みから掘り起こさなければならないときよりも、はるかに当てにできます。この非対称性が、本書のエンジニアリングの半分の種になっています。検索、ツール、そして第III部で扱うコンテキストエンジニアリングという分野全体は、根本的には、荷重を支える事実を1つ目の場所から2つ目の場所へ移す方法なのです。
これがエンジンです。言語を相手にする仕事(下書き、書き直し、要約、翻訳、説明、コードの変換)には抜群に優れていますが、データベースや電卓としては当てになりません。しかも自信のダイヤルは、永久に「高」に張りついたままです。エージェントはこのエンジンに、コンテキストという鍵穴からしか見えない世界について、いくつもの判断を立て続けに下すよう求めます。次に向かうのは、その鍵穴です。
トークンとコンテキストウィンドウ
モデルがその時点で知っていることは、すべてその鍵穴を通ってやってきます。だから、鍵穴の大きさを測っておいたほうがよいでしょう。第1章で必要だったのは、コンテキストウィンドウの定義、つまりモデルが1回の呼び出しで考慮できる、長さに上限のあるテキストという定義くらいでした。この節では、その絵を細かく描き込んでいきます。出発点は、ウィンドウを測る単位です。開発中にぶつかる制限のほとんどすべて(モデルが見られる量の上限、月末の請求額、答えが始まるまでの待ち時間)が、トークンを単位として決まるからです。前の節では、紙ナプキンの裏に書く程度の説明をしました。トークンとはテキストの断片で、平均すると英単語のおよそ4分の3だ、というものです2 単語の4分の3という目安(言い換えれば、英語では1トークンあたり約4文字)は、OpenAIのヘルプセンターの記事“What are tokens and how to count them?”によるものです。これは英語の散文についての大まかな平均であって、定数ではありません。。この大ざっぱな説明は、現実の設計上の問題を覆い隠しています。そしてその問題の解決策が、そうと知らなければただの愚かさにしか見えない、いくつかの振る舞いを説明してくれます。
設計上の問題とはこうです。モデルには固定された語彙が必要です。ありうるすべての入力と出力を組み立てるための、有限な断片のメニューです。メニューが単語単位だったとしましょう。語彙は膨れ上がります。love、loves、loved、lovinglyにそれぞれ専用の項目が必要になり、しかも最初のタイプミスや、創作された名前や、学習後に生まれた単語には、項目がまったくありません。では、メニューが1文字単位だったらどうでしょう。今度は表現できないものはなくなり、語彙はごく小さくなりますが、どんなテキストも、ほとんど意味を持たない単位がとてつもなく長く並んだ列になります。本番で使われるモデルは、この2つの間の妥協点に落ち着いています。それがサブワードトークン化です。アルファベットよりはるかに大きく、あらゆる語形を収めた辞書よりはるかに小さい断片の固定語彙を使い、よく使われる単語は1つのトークンとして扱い、まれな単語は部品から組み立てます。たとえばannoyinglyはannoying + lyに、unhappinessはun + happi + nessになるかもしれません3 Hugging Faceのトークナイザーのドキュメント(“Summary of the tokenizers”)は、標準的なサブワードアルゴリズム(BPE、WordPiece、Unigram)を説明し、こうした分割の例で図解しています。実際に手を動かして深く学びたいなら、Andrej Karpathyの講義“Let’s Build the GPT Tokenizer”が、トークナイザーをゼロから作り、それが引き起こす奇妙な振る舞いをひととおり見せてくれます。。頻出する文字列は安く表現され、どんな文字列も、より小さな部品に頼れば必ず表現できます。
切り分けを行う機械、つまりトークナイザーには、短い段落を充てる価値があります。人が思っているよりはるかに単純だからです。トークナイザーは固定された決定論的な変換表で、モデルと一緒に一度だけ作られ、モデルの一生を通じて凍結されています。入口では、あなたのテキストを整数IDのリストに変換し、出口では、モデルが選んだIDをテキストに戻します。これが何を意味するかに注目してください。ネットワークは、あなたが書いた文字を決して目にしないのです。モデルの側から見れば、世界は番号の振られた断片の列であり、断片の内側で起きていることは、モデルが関わる前に消し去られています。
この消去は試すことができますし、ぜひ自分で試してみることをお勧めします。モデルに、ありふれた英単語に文字rがいくつ含まれるかを尋ねるか、英単語を逆から綴らせてみてください。モデルは何年もの間、まさにこうした質問でつまずいてきました。ときには滑稽なほどに、しかも本当に難しい問題を解いてみせたのと同じ会話の中で、です。このパターンは、トークナイザーを念頭に置いた瞬間に、不条理には見えなくなります。その単語は1つか2つの中身の見えない断片として届いたのであり、断片の中の文字こそ、変換表が捨てた情報そのものなのです。文字を数えるには、モデルは学習中にその単語について吸収したものから綴りを再構成しなければなりません。それは記憶の課題であり、しかも当てにならない課題です。(あなたがこれを読む頃には、試したモデルは難なく正解するかもしれません。こうした穴は学習によってふさがれるか、モデルがそっとツールに手を伸ばすからです。それでも、この失敗があらわにした仕組みは、いまも下に横たわっています。)数字も同じことを物語ります。広く使われているあるトークナイザーでは、520は1つのトークンなのに、521は5 + 21に分かれます4 どの数字が分かれるかは、各トークナイザーの学習で決まる恣意的な事実です。たとえばGPT-2/GPT-3世代のバイトペアトークナイザーでは、520は1トークンですが、521は5 + 21になります。後のトークナイザーは短い数字をひとまとまりに保つ傾向がありますが、長い数字はやはり不規則に区切ります。要点は、分かれる数字があり、モデルは断片の内側を見ることができない、ということです。。そのためモデルは、数の体系を無視した断片の上で算術を行うことになります。モデルの暗算が、その流暢さから想像されるより危なっかしい理由の1つです。この教訓は一般化できます。モデルの世界には木目があり、その木目がトークンなのです。
トークン化の結果のうち、作り手にとって内部の仕組みよりも重要なものが3つあります。第一に、1単語あたりのトークン数は内容によって変わります。コード、数字、構造化データは散文よりトークン化の効率が悪いので、1ページのJSONは1ページのエッセイより多くのトークンを消費します。第二に、ほとんどのトークナイザーは主に英語で学習されているので、同じ意味でも、別の言語では何倍ものトークンがかかることがあります。ある分析では、ビルマ語が同じ内容の英語のおよそ8倍のトークン数になっていました。格差を示すための例示として挙げる数値であって、定数ではありません5 Aleksandar Petrov et al., “Language Model Tokenizers Introduce Unfairness Between Languages,” NeurIPS 2023(arXiv:2305.15425)。さまざまなトークナイザーにわたって、最大でおよそ15倍の格差を測定しています。ビルマ語についての約8倍という数値は、トークナイザーの学習で十分に扱われていない言語で、格差がどこまで広がりうるかを控えめに示したものです。。あなたのユーザーがさまざまな言語で書くなら、これはコストと公平性に直結します。第三に、あなたが考えもしないような区別が、トークナイザーにとっては現実のものです。同じ単語でも、先頭に空白があるかないか、大文字で始まるかどうかで、まったく別のトークンになりえます。この3つすべてから導かれる実践的な習慣があります。数が重要なときは、プロバイダー自身のトークナイザーやトークン数を数えるエンドポイントで、実際のテキストを測ってください。モデルのファミリーごとにテキストの区切り方は違うので、あるモデルから借りてきた数は、別のモデルにとっては推定値にすぎません。(この節の数字のほとんどすべてに「およそ」や「約」がついていることに、いま気づきました。トークナイザーについては、「およそ」と言うのが誠実な口調なのです。)
では、ウィンドウそのものの話に移りましょう。ここでも本書の残りでも、私はこれを机として描きます。鍵穴のモデル側にある作業面で、モデルが1回の呼び出しの間に参照するものは、すべて同時にその上に載っていなければなりません。典型的なエージェントの呼び出しで、その机に広げられているのは、あなたの常設の指示、ここまでの会話全体、エージェントが使う可能性のあるすべてのツールの定義、返ってきたすべてのツール結果の全文、タスクのために取ってきた文書、そしてモデルが書いている最中の答えです。答えも、伸びるにつれて同じ机の上に載っていきます。そのすべてを、1つのトークン予算がまかないます。引き出しも、棚も、2つ目の机もありません。ある事実がこの呼び出しの間に机の上にあれば、モデルはそれを使えます。宇宙のどこか別の場所にあるなら、この呼び出しの間、それは存在しないのと同じです。
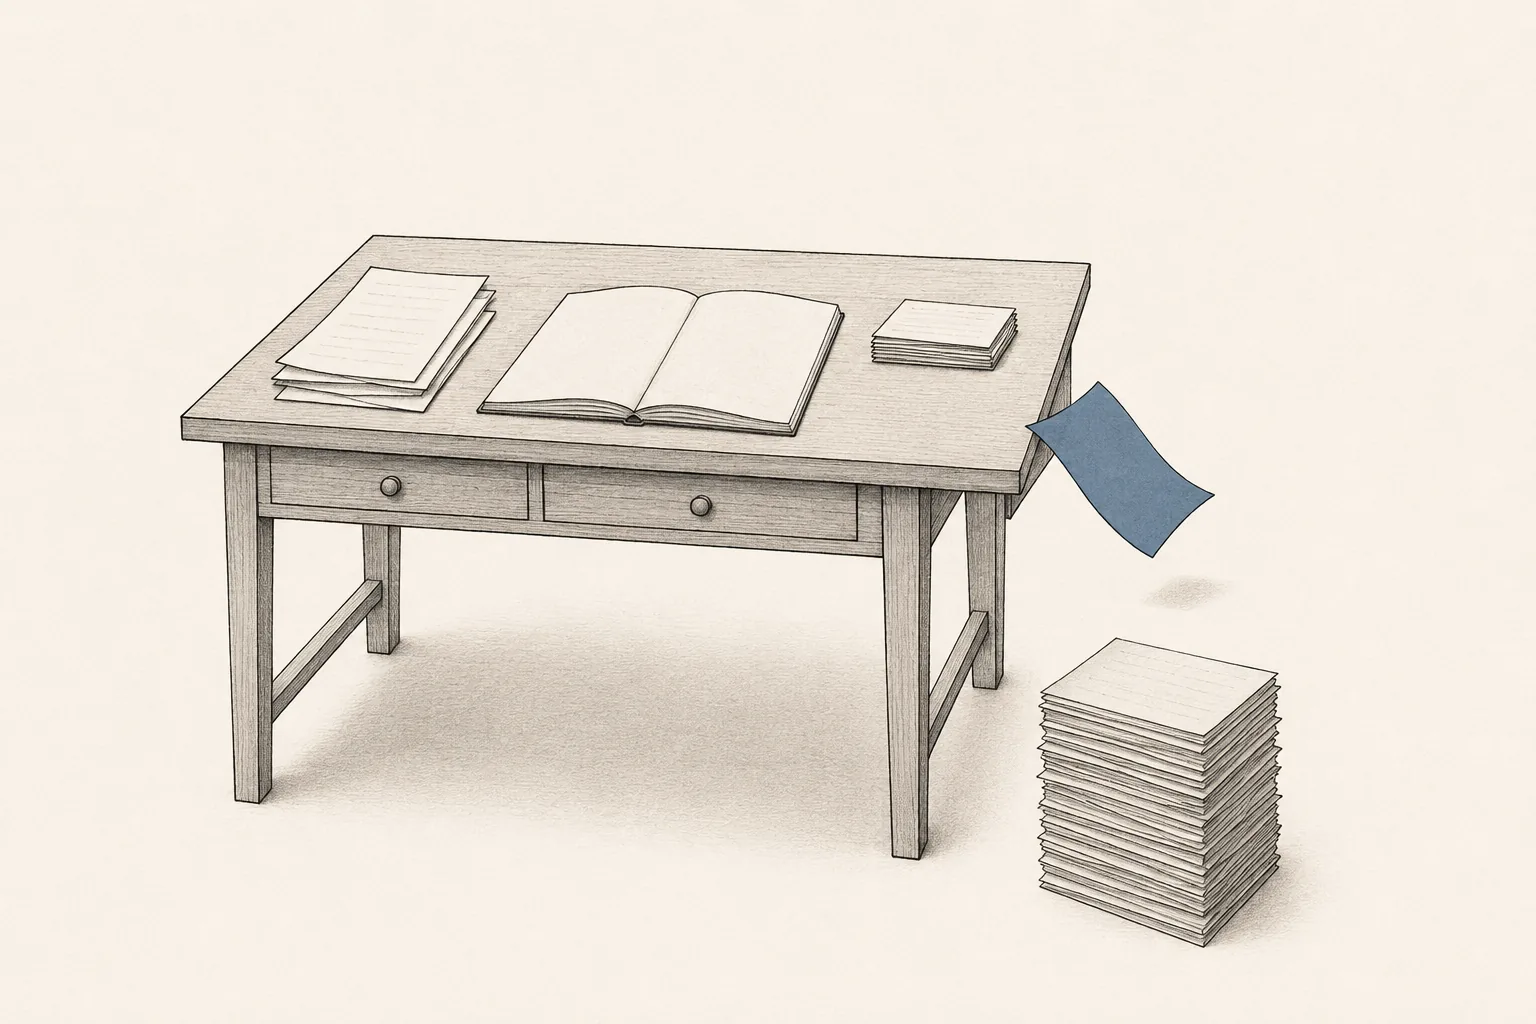
机はまた、呼び出しと呼び出しの間に何もない状態に片付けられます。ここで、この比喩の正直な限界を示しておく必要があります。あなたの作業記憶は午後まで持ち越されますが、モデルの作業記憶は次のリクエストまで生き残りません。LLMのAPIはステートレスです(呼び出しのたびに、何もないところから始まります)。このことが、前の節で述べた記憶についての話に、運用上の形を与えます。会話を続けるために、周囲のソフトウェアは毎ターン、実行記録全体を机の上に並べ直すのです。最新のメッセージに返信する前に、メールのスレッド全体を読み直すようなものです。この習慣は、メッセージが3通なら害はありませんが、300通なら破滅的です。作り物ですが現実的な数字で、ざっと見積もってみましょう。常設の指示が500トークン、ここまでの会話が8,000、取ってきた文書2つで40,000、最新のツール結果が3,000。モデルは1語も書かないうちに5万トークン以上を読み、あなたはその1つ残らずに料金を払います。そして次のターンには、山はさらに大きくなっています。このターンが履歴に加わったからです。(変わらない山を読み直すコストは、プロバイダーがキャッシュで和らげてくれます。第19章の主要なレバーの1つです。)
山が収まらなくなったら、何が起こるのでしょうか。優雅なことは何も起こりません。APIや間に挟まるソフトウェアによっては、リクエストがエラーで即座に拒否されることがあります。入力が切り詰められることもあります。収まるまで削られるのです。たいていは最も古いターンから捨てられ、しかも誰にも知らされないことが少なくありません。あるいは、間に入ったフレームワークが、送る前に履歴を要約することもあります。即座のエラーは、まだ親切な結果です。厄介なのは気づかれない切り詰めです。呼び出しは成功し、答えは流暢に返ってきますが、モデルは一部を切り落とされた実行記録の上で推論していて、そこからはあなたの最初の指示が人知れず抜け落ちているかもしれません。外から見ると一晩で頭が悪くなったモデルのように見えるので、そのぶんデバッグの時間が燃えていきます。長いセッションが「忘れ」はじめたら、モデルを責める前に、あふれていないかを確かめてください。(この驚きの親戚もあります。入力と出力はウィンドウを共有しますが、多くのモデルは、1回の応答の長さを別途、はるかに小さい値に制限しています。文の途中で止まった答えは、たいてい出力の上限に達したのです。)
机の性質をもう1つ挙げておきます。第1章ですでに漏らしてしまったものです。収まっているものでさえ、均等には使われません。長い入力では、モデルは先頭近くと末尾近くの内容を、真ん中に埋もれた内容よりもはるかによく思い出します。羅針盤のところでは、そうした事実を「半分忘れられている」と呼びました。研究の文献はこの効果を、言い得て妙なことに「Lost in the Middle」(中ほどの情報が見失われる現象)と呼んでいます6 Nelson F. Liu et al., “Lost in the Middle: How Language Models Use Long Contexts,” Transactions of the Association for Computational Linguistics(2024年)。長いコンテキストを扱うタスクの精度は、関連する一節が入力の先頭か末尾にあるときに最も高く、真ん中にあるときには落ち込みました。。したがって、机を大きくしても、見た目ほどには問題は解決しません。端はくっきりしたままで、真ん中が広がるだけだからです。これが、本書の2つ目の方位であるコンテキストの希少性の、仕組みの上での根拠です。そしてそれが強いる技術、つまりそもそも何を机に載せる価値があるかを決めることが、第7章に始まる第III部の全体を占めます。
すべてが収まり、思い出しやすい位置にあるときでさえ、山は決してただではありません。トークンは、入力と出力の両方向で、あなたの請求額の単位です。待ち時間の単位でもあります。モデルは答えの最初のトークンを出す前に、山全体を読まなければなりません。この段階をプリフィルと呼びます。そして標準的なアーキテクチャでは、この読み込みのコストは長さとともに急激に、おおよそ長さの2乗のオーダーで増えていきます。膨れ上がったコンテキストは、追加の内容が役に立つかどうかにかかわらず、エージェントが答えはじめるのを遅くし、1回1回の呼び出しを高くつかせます。ウィンドウは上限であって、目標ではありません。問うべきは、タスクを実際に収められる最も小さな机はどれか、です。
チャットボットにとって、これらは背景にある事実にすぎません。エージェントにとっては、毎日つきあう条件です。ループはステップのたびに、推論、ツール呼び出し、ツール結果を何度も何度も机に追加していきます。そして、キュレーションの仕組みをあなたが作らないかぎり、誰もその山をキュレーションしてはくれません。20ステップ進む頃には、実行記録は古くなったディレクトリ一覧や、半分しか関係のないページの中身で重くなり、本当に大事な指示は、思い出す力が落ち込む山の真ん中に埋もれています。そしてそれ以降のステップは、そのたびに、積み上がったもの全体を読み、その分を請求してきます。これで机は測り終えました。仕組みとして残っているのは、書くことそのものです。モデルが順位付きの推測から1つのトークンをどう選ぶのか、そして、まったく同じエージェントを2回実行しても同じ振る舞いをしないのはなぜか。それが次の話題です。
テキストはどう生成されるのか
モデルに「猫が座っているのは」という断片を渡すと、この章の冒頭で説明したとおり、順位付きのリストが返ってきます。語彙に含まれるすべてのトークンについての確率です。そのリストの上位が、マットが0.42、床が0.18、ソファが0.13、ラグが0.09で、残りのわずかな確率が何千もの泡沫候補に散らばっているとしましょう。(数字は作り物ですが、形は典型的なものです。)さて、この節の要となる問いです。読み進める前に、答えを1つに決めてください。モデルはどの単語を書くでしょうか。当然に思える答えはマットです。いちばんよい推測を取ればいいのであって、機械がそれ以外のことをする理由はないように思えます。ところが、あなたがこれから呼び出すほとんどのシステムでは、その答えは間違っています。デフォルトでは、仕組みはサイコロを振るのです。
問題のステップ、つまり順位付きのリストを1つの選ばれたトークンに変えることをデコーディングと呼びます。当然に思える戦略にも名前がついています。貪欲デコーディング、つまり常に最も確率の高いトークンを1つ選ぶ方法です。貪欲法は決定論的で、安く、責任ある選択のように聞こえます。しかし同時に、よく知られた病気を抱えたテキストを生みます。平板で、妙に繰り返しの多い文章です。ループにはまり込み、同じ言い回しが何度も何度も浮かんでくることもあります7 Ari Holtzman et al., “The Curious Case of Neural Text Degeneration,” ICLR 2020。この論文は、最大化型のデコーディングが繰り返しへと劣化する様子を記録し、その対策として核(top-p)サンプリングを導入しました。。その理由は直感に反するので、きちんと説明しておく価値があります。人間の文章は、意外な形容詞や新鮮な言い回しといった小さなリスクをとりつづけます。一方、決して賭けをしないデコーダーは、言語の最も無難な片隅へと流れていき、そこをぐるぐる回りはじめます。局所的に最も安全な単語を毎回選ぶと、全体としては凡庸な一節ができあがるのです。
もう1つの道、そしてほぼどこでもデフォルトになっているのがサンプリングです。次のトークンを、モデルの確率で重み付けしてランダムに引くのです。マットは100回のうち42回くじに当たり、ラグにもおよそ100回に9回は順番が回ってきます。覚えておくべき絵は、1トークンにつき1回行われる重み付きのくじ引きです。モデルが当たりの確率を刷り出し、デコーダーがくじを引きます。あなたがこれまでに感心した、流暢で自然に聞こえる答えはどれも、こうして1回ずつくじを引いて組み立てられたものです。そして、あなたが将来作るエージェントの性質の1つが、エージェントがまだ1つも存在しないこの段階で決まっています。ばらつきは設計に組み込まれているのです。まったく同じ2つのリクエストが違うくじを引くことがあり、一度でも引いたくじが違えば、2つのテキストはそれきり別々の道を行きます。後のトークンはどれも、それより前のトークンを条件として生成されるからです。
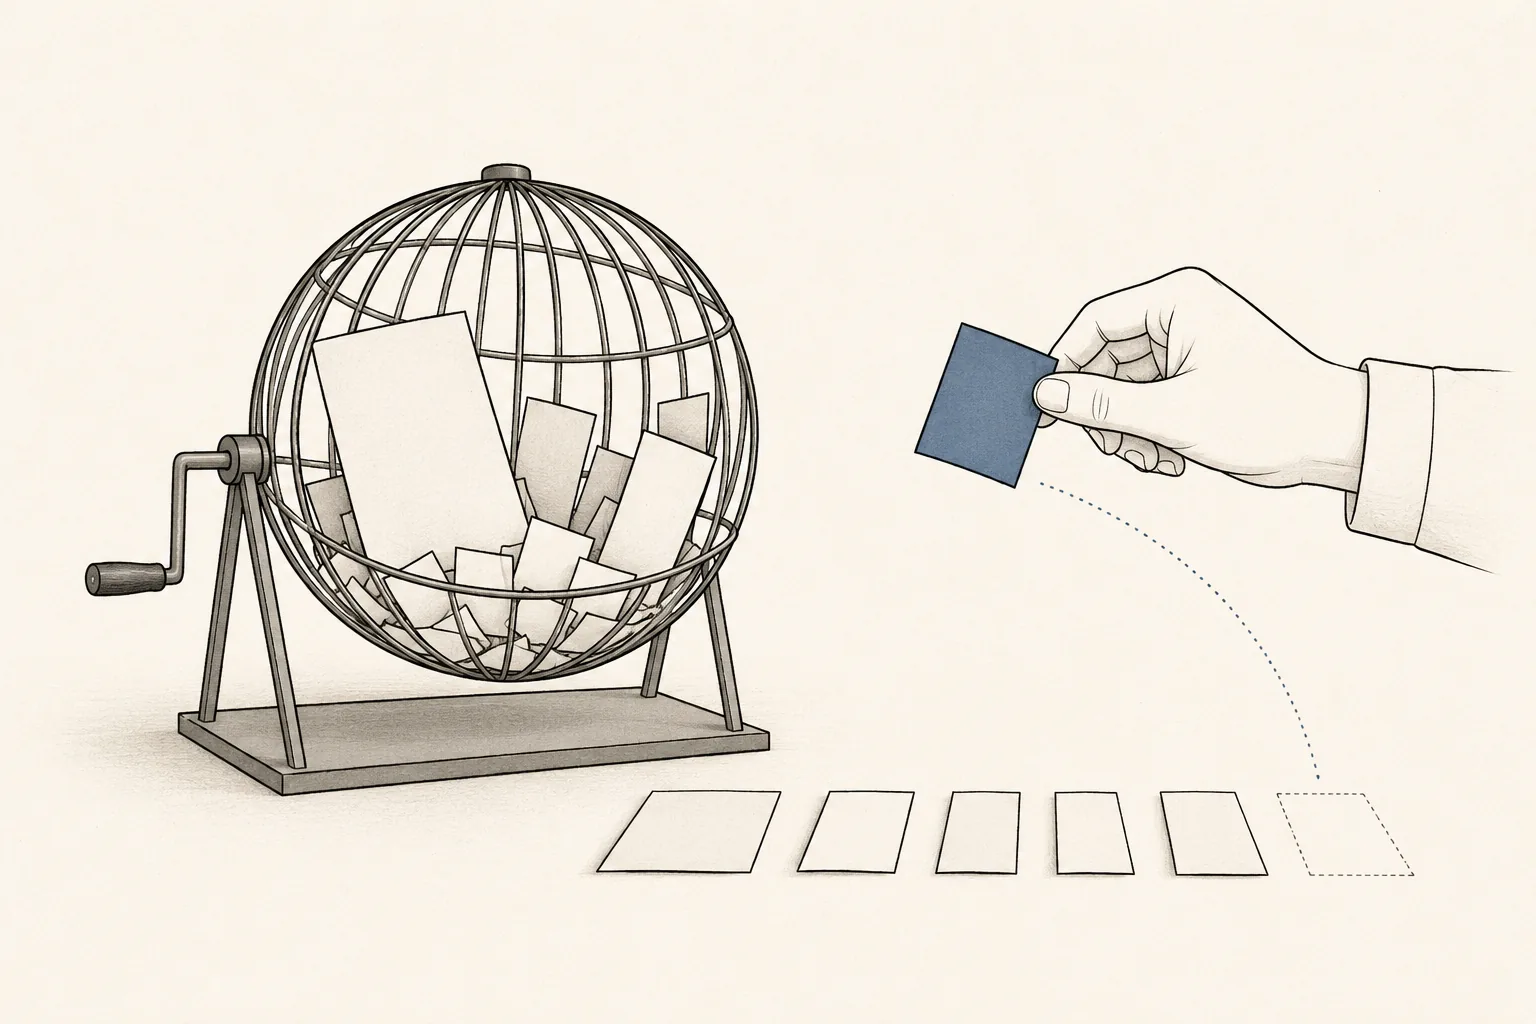
貪欲と無秩序の間には、いくつかのつまみがあります。どれもしていることは1つで、くじを引く前に、順位付きのリストの形を変えるか、刈り込むかです。どのつまみも予測の下流で働きます。順位付きのリストそのものは決まっていて、つまみが左右するのは、そこからどう選ぶかだけです。温度は鋭さのダイヤルです。下げると、本命と大穴の差が広がっていき、ゼロでは最上位のトークンが毎回当たるので、貪欲法に戻ります。上げると、出走馬の差が縮まり、大穴にも本当の勝ち目が生まれ、最後にはテキストがノイズに溶けていきます。このダイヤルが何と何を引き換えにしているかに注目してください。低い温度は一貫性を買い、高い温度は多様性を買います。そして正しさは、どちらの端にもありません。間違った答えは、どの設定でも自信たっぷりに引き当てられうるのです。
ほかによく使われる2つのつまみは、リストの形を変えるのではなく、候補を刈り込みます。top-kは、確率の高いほうからk個のトークンだけを残し、残りを捨てます。単純ですが、kは固定された候補の数であり、本当にもっともらしい続きの数は、その時々で大きく変わります。top-p(核サンプリング、nucleus samplingとも呼ばれます)は、確率の合計が少なくともpに達する上位トークンの最小の集合を残すことで、この問題を補います。「フランスの首都は」のあとでは、候補はトークン1つだけかもしれません。「私の好きな食べ物は」のあとでは、何十個にもなるかもしれません。候補の数がモデル自身の確信度に合わせて伸び縮みするので、top-pはよくあるデフォルトになっています。実践上の指針は短いものです。設定はタスクで選んでください。プログラムがパースしたりテストがチェックしたりするものには低い温度を、ブレインストーミングや下書きにはもう少し高い温度を使います。そして、つまみは一度に1つずつ調整してください。いくつかのつまみは、同じ分布を絞っているからです。
生成はいつか終わる必要があり、その終わり方は3通りです。1つ目に、モデルが特別なシーケンス終了トークンを出力することがあります。「終わりました」と語彙の形で言うことを、学習で教わったのです。これが正常系です。2つ目に、厳格な最大長の上限が、思考の途中で出力を断ち切ることがあります。前の節で出会った、文の途中で止まる答えがこれです。3つ目に、呼び出し側が指定した停止シーケンス(あらかじめ指定しておく文字列で、区切り記号であることが多い)が生成されたその瞬間に、生成が終わります。いまのうちに身につけておきたい習慣が1つあります。APIは一般に、応答がこのうちどれで終わったかを報告します。そのフィールドを読んでください。長さの上限で切り詰められた返答は、モデルの失敗とまったく同じに見えますが、実際にはあなたが設定した予算なのです。
さて、前の節で宙に浮いたままだった問いに戻りましょう。まったく同じエージェントを2回実行すると、結果が違うのはなぜでしょうか。ばらつきの1つ目の原因は、目に見えるところにあります。サンプリングはくじ引きなので、温度がゼロより大きければ、同じプロンプトでも違うくじを引いて分岐し、二度と合流しないことがありえます。この原因は意図されたもので、完全にあなたの制御下にあります。温度をゼロにすれば、くじ引きは決定論的になります。理論上は。
いま手にした直感で、予測をしてみましょう。1つのプロンプトを、ホスティングされたモデルに温度ゼロ(貪欲デコーディング、くじ引きなし)で1000回送るとします。異なる答えはいくつ返ってくるはずでしょうか。頭の中の計算は1つだと言います。ある研究チームが実際にこの実験を行ったところ、返ってきたのは80通りでした。1000件の補完はすべて、最初の102トークンまでは同一でした。103番目のトークン、つまり文がある伝記の主人公の出生地に差しかかったところで、992件はある言い回しを、8件は別の言い回しを選び、その分岐点から先の出力は広がっていきました8 Horace He et al., “Defeating Nondeterminism in LLM Inference,” Thinking Machines Lab(2025年)。実験では、「Tell me about Richard Feynman」(リチャード・ファインマンについて教えて)に対する温度ゼロの補完を1,000回行ったところ、80通りの異なる出力が得られました。どれも102番目のトークンまでは同一で、最初に分かれたのは出生地の言い回し(「Queens, New York」対「New York City」)でした。数値はこの現象を示す例であり、自然の定数ではありません。。よく聞く説明は並列ハードウェアでの丸め誤差のせいにしますが、それでは不完全です。より完全な説明は、バッチ不変性(batch invariance)と呼ばれる性質、正確にはその欠如にかかわります。ホスティングされたエンドポイントは多くの顧客に同時にサービスを提供し、効率のために、それぞれのリクエストをまとめてバッチにします。バッチの大きさはトラフィックに応じて増減します。そしてモデル内部の低レベルな数値計算ルーチンは、バッチの大きさが違うと、ごくわずかに異なる結果を返すことがあります。ごくわずかで十分なのです。順位付きのリストの最上位で2つのトークンがほぼ並んでいるとき、たとえば小数点以下6桁目の揺らぎが勝者を決め、貪欲法は忠実にそれを選び、テキストは分岐します。APIのこちら側から見れば、決め手となる入力は、その同じ瞬間に同じサーバーにたまたま問い合わせていた見知らぬ人の数です。あなたには見ることも、制御することも、リプレイすることもできない入力です。バッチ不変なルーチンは存在し、実際にこの問題を解決しますが、サービングの速度という代価を伴います。本書の執筆時点では、まだ例外的な存在です。だから温度ゼロは、ほぼ常に守られる強い希望として扱ってください。そして、「ほぼ常に」がすべてのステップのすべてのトークンで試されつづければ、驚きの入り込む余地が残ることを忘れないでください。
作り手は、こうしたことすべてをどう受け止めればよいのでしょうか。3つの習慣があります。第一に、文字列の完全な再現性を土台にするのはあきらめてください。出力の性質をアサートするテストを書きましょう。パースできる、正しい顧客の名前を挙げている、チェッカーを通る、といった性質です。1バイトも違わない一致をアサートするテストは、あなたの時間を何週間も無駄にさせる形でフレーキーになります。第二に、一度見た失敗は、再現させようとしてもなかなか再現しないものだと思っておいてください。それはインフラについての事実です。第15章では、そうした失敗でもデバッグできるようにする記録の道具を作ります。第三に、エージェントならではの帰結を実感してください。エージェントはすべてのステップのすべてのトークンでこのくじ引きを行い、各ステップの出力が次のステップの入力になるので、実行ごとのばらつきはループに沿って累積していきます。同じタスクで、違う経路をたどり、どちらももっともらしい。この分野で長く通用してきた対応は、出力を同一にすることではなく、結果を確かめられるようにすることです。第1章の検証可能性という方位が、ここで仕組みの上での根拠を伴って再び現れます。
つまり、機械はくじ引きで書き、くじ引きがその多様さを説明します。次の問いは、どうやって誘導するかです。重みが凍結され、サイコロが無関心だとしたら、残されたレバーは、あなたが机の上に並べるテキストだけです。何を言うか、どの順番で言うか、そして例として何を見せるか。そのレバーが次の節の主題です。
プロンプトの基礎
この機械に対して、あなたが実際に手にしているレバーを数えてみましょう。重みは凍結されています。推論時にあなたが何をしても、重みは変わりません。前の節のサンプリングのつまみは、順位付きのリストからトークンをどう引くかを調整するだけで、モデルがそもそも何を予測したかには手を触れません。それ以外のすべては、ただ1つの道具に行き着きます。あなたが何を書くかです。そのテキストがプロンプトであり、それをうまく書く技術がプロンプトエンジニアリングです。書くことと実験とが半々の営みにしては大仰な名前ですが、エージェント的なものすべての土台となる、基本的な誘導の技能です。その基礎はこの1節に収まります。何年もモデルにプロンプトを書いてきた人でも、読み直す価値はあります。エージェントはループの各ステップで新しいプロンプトを組み立てるので、ここでの弱点は、あとで作るものすべてで繰り返される弱点になるからです。
まずは構造から見ていきます。現代のチャットモデルはメッセージのリストを受け取り、各メッセージにはロールがついています。ほぼどこでも共通するロールが3つあります(正確な名前や通信形式はプロバイダーによって違うので、特定の構文はベンダーごとの細部として扱ってください)。system(システム)メッセージは常設の指示を運びます。モデルが何者として振る舞うべきか、何をしてよくて何をしてはいけないか、答えがどんな形をとるべきか、です。一度書かれ、すべてのターンにわたって持続します(周囲のソフトウェアが呼び出しのたびに再送するのです。思い出してください、モデル自身は何も保持しません)。user(ユーザー)メッセージは、その時点の依頼を運びます。この質問、このチケット、このファイル、です。そしてassistant(アシスタント)メッセージはモデル自身の返答で、会話の履歴として積み重なっていきます。便利なことに、assistantメッセージを自分で書くこともできます。モデルに言わせたい言葉をあらかじめ書き込んでおくことで、よい答えがどんなものかを、説明する代わりに実際に見せるのです。私の仕分けのルールはこうです。ある指示を毎ターン繰り返さなければならないなら、それはsystemメッセージに属します。この1つのリクエストに固有なら、userメッセージに属します。これを混同すると、あとで高くつきます。userメッセージのたびに繰り返し書き添えるルールは、呼び出し側の全員が書き添えるのを忘れないかぎりでしか生き延びません。図2.4は、3つのロールと、呼び出しのたびにスタック全体を再送させるステートレス性を図示したものです。

最大のレバーは明確さです。仕組みについての2つの節を読んだいまなら、なぜそれが効くのかがわかるはずです。モデルはテキストの続きを書きます。あいまいな指示は順位付きのリストを広いままにし、くじ引きは、あなたが空けておいた空間をどこまでも嬉々としてさまよいます。正確な指示は、サイコロが振られる前に候補を絞り込みます。実践では、これは形容詞よりも強制できる制約を選ぶということです。「3〜5文で」は「短く」に勝り、「箇条書きは5項目まで、各項目30字以内」は「簡潔に」に勝ります。各組の前者はチェックでき、後者は気分にすぎないからです。また、してほしくないことを述べるということでもあります。モデルは学習で身につけた親切さから、やりすぎる傾向があるからです。「価格をでっち上げないこと」「顧客が返金を求めても、返金を約束しないこと」。そして、タスクが実行できない場合の逃げ道を用意するということでもあります。「答えが与えられたテキストの中にないなら、十分な情報がないと言うこと」。この最後の1行がないと、答えを持たないモデルは、学習で教わったとおりのことをします。つまり、答えるのです。
以上の構造を組み立てると、次のようになります。ひと目で読めるほど小さなものです。
あなたはサポートチケットのトリアージアシスタントです。
以下のチケットを、必ず次のどれか1つに分類すること:
  billing, bug, feature-request, other.
チケット:「設定を開くたびにアプリが落ちます。」
カテゴリー名を1つだけ答え、ほかには何も書かないこと。5行で、4つの役割。範囲を定めるロール、許される答えを閉じた集合として示す指示、入力データ、そして出力の契約です。本当に仕事をしているのは厳格な言い回しのほうです。「必ず次のどれか1つ」、固定されたリスト、「ほかには何も書かないこと」。これを実行すれば、有能なモデルはほぼ毎回bugを返します。
ほぼ毎回、です。20回に1回、返事が大文字と終止符のついた「Bug.」や、「設定画面のバグのようです。」で返ってくるとしましょう。パーサーは詰まり、指示をいくらにらんでも欠陥は見つかりません。標準的な次の一手は、例を加えることです。
チケット:「今月、二重請求されています。」  -> billing
チケット:「ダークモードが欲しいです。」    -> feature-request
チケット:「設定を開くたびに
アプリが落ちます。」 ->指示だけでプロンプトを書くことをゼロショット(zero-shot)と呼び、このような実例を加えることをフューショット(few-shot)と呼びます。そして、モデルがそのパターンを拾い上げる能力にも独自の名前があり、インコンテキスト学習(in-context learning)と呼ばれます。モデルは、再学習を一切せずに、プロンプトの中の例からあなたのタスクに適応するのです。例が教えるのは、先ほどの失敗で欠けていたとわかったもの(形式と文体)に加えて、指示ではうまく説明できない3つ目のもの、すなわち境界例の扱いです。ここには示唆に富む研究結果があります。例示の効果の多くはその構造(一貫した形式、目に見えるラベルの集合)から来ていて、個々のラベルの一部が間違っていてもなお残るというのです9 Sewon Min et al., “Rethinking the Role of Demonstrations: What Makes In-Context Learning Work?,” EMNLP 2022。ラベルをランダムに入れ替えた例示でも、正しくラベル付けされた例示の効果の多くが保たれました。形式とラベルの空間が、効果のかなりの部分を担っていたのです。。例は、答えの形をなぞるための型紙として働きます。よく選んだ2つか3つの例で、得られる効果の大半は手に入ります。例を1つ増やすごとに、呼び出しのたびに(エージェントの場合はステップのたびに)トークンがかかり、見返りは小さくなっていきます。
例示では手に入らないものも知っておいてください。モデルが推論を誤るタスクは、完成した答えをいくつ前に並べても、間違ったままになりがちです。推論そのものを例として見せるのは別の手法で、第4章で独自に扱います。ここから導かれる段階的な手順は、ありがたいほど単純です。まずゼロショットで始める。出力の形がぶれたら、例を2つか3つ加える。問題が中身にあるなら、ほかを当たる。
下流で何かが出力形式に依存するなら、形式にはそれ専用の明示的な指示を与えるべきです。人間向けの文章なら、セクションの名前、その順序、長さの範囲を指定します。プログラムがパースする出力なら、形をはっきり述べます。そして、指示は依頼であって、保証ではないことを理解しておいてください。モデルは「カテゴリー名を1つだけ答え、ほかには何も書かないこと」を1000回守ったあとで、1001回目に、その単語を丁寧な文で包むことがあります。パースが重要な場面では、依頼を契約に格上げできます。その格上げが次の節の主題です。
プロンプトの中で最も民間伝承めいた一角、ペルソナについても一言触れておきます。モデルに何者であるかを告げること(「あなたはシニアのセキュリティレビュアーです」「あなたは野外図鑑のような文章を書きます」)は、口調、文体、範囲を確実に形づくります。自由な文章を書かせるなら、それはまさに求めていたレバーであることが多いでしょう。民間伝承はさらに先まで行き、ペルソナは答えをより正確にもすると言います。専門家になれと言えば、専門家になるというのです。研究が描く姿は、それよりはるかに見劣りのするものです。事実や分析にかかわるタスクでは、単純なペルソナが有能なモデルに与える効果はまちまちで、多くの場合は無視できる程度です10 Mingqian Zheng et al., “When ‘A Helpful Assistant’ Is Not Really Helpful: Personas in System Prompts Do Not Improve Performances of Large Language Models,” Findings of EMNLP 2024。PromptHubのまとめ記事“Role-Prompting: Does Adding Personas to Your Prompts Really Make a Difference?”は、この研究と関連する研究を集めています。領域に合わせて作り込んだペルソナは一部の設定で効果を示していますが、飾り気のない「あなたは専門家です」は、一般に効果を示していません。。ペルソナは口調と境界を設定するために使い、正しさのためには、指示、例、そして本物の推論の支えを使ってください。
置き方についての2つの習慣で、道具箱は完成します。第一に、タスクにいくつかの部分があるなら、全体をほのめかす(「エンティティを抽出して」)のではなく、順序のあるステップとして書き出してください(「まず会社名を挙げ、次に人名を、それから繰り返し現れるテーマを挙げて」)。明示的なステップは出力をよくし、それと同じくらい価値のあることに、失敗したときにどのステップで失敗したのかを教えてくれます。この直感には、第4章で、エージェントがプロジェクト全体を分解する場面で、成長した姿で再会することになります。第二に、位置が重要です。プロンプトの冒頭に何ページもの資料(文書、実行記録、ツール結果の山)があるなら、指示はその山のあとに置き、荷重を支えるルールを1つ、末尾の近くで繰り返してください。その理由は2つあり、どちらもすでにあなたが手にしているものです。モデルは続きを書くものなので、文書の途中で終わるプロンプトは、タスクではなく文書の続きを誘ってしまいます。そして机の端はくっきりしたままで真ん中は落ち込むので、最後の数行は思い出す力が最も強い場所に置かれます。モデルが最後に読むものは、あなたがモデルに何よりもしてほしいことであるべきです。
これらすべてを合わせれば科学になる、とは言いません。プロンプトは経験的な対象です。あなたが同じだとみなす2つの言い回しが違う振る舞いをすることもありますし、今日うまくいくプロンプトが、背後のモデルがアップグレードされたときにずれていくこともあります。プロンプトはコードと同じように扱ってください。バージョン管理し、テストし、モデルが変わるたびにテストし直すのです。そのための仕組みは第16章で作ります。そして、この節が向かってきた捉え直しを手放さないでください。エージェントでは、最終的なプロンプトを打ち込む人は誰もいません。systemメッセージは一度書かれるだけで、ツール定義は仕組みによって差し込まれ、履歴はターンごとに積み重なり、取得した文書やツール結果は、実行時にコードが所定の位置に差し込みます。上で述べた原則は、どれもいまも当てはまります。モデルが読むものを選ぶ誰かがいることに変わりはありません。ただ、その誰かが、あなたの書くプログラムになるのです。ステップのたびに、何が机の上に場所を得るに値するかを決めることは、独自の名前を持つに足るほど大きな問題です。それがコンテキストエンジニアリングであり、本書の第III部はそれに充てられています。とはいえ第III部はまだ先で、もっと近い穴が目の前にあります。指示は形式を依頼することしかできません。次の節では、それを保証する方法を示します。
構造化出力と関数呼び出し
第1章では、関数呼び出しをテキストから行動への橋と呼び、その仕組みはこの章で示すと約束しました。この節でその約束を果たします。出発点は、モデルの出力を誰が読むのかという問いです。人間が読むかぎり、言い回しは自由にさまよってかまいません。人は大目に見てくれます。プログラムが読むようになった瞬間、言い回しがさまようと物が壊れます。そしてエージェントがすることは、すべて、プログラムがモデルの出力を読むことにかかっています。
解決する前に、問題を肌で感じてみましょう。あなたのコードがモデルに、顧客からのメールから2つの事実(顧客の名前と注文の合計額)を抜き出させ、データベースに書き込もうとしているとします。3回実行して、3つの答えが返ってきました。どれも文章としては正しいものです。
名前:Ada、合計:$42
お客様はAda Lovelaceさんで、四十二ドルお支払いになりました。
喜んで!Adaさんのご注文の合計は$42.00です(請求書 #1041)。読み進める前に、この3つすべてを処理できるパースのコードを考えてみてください。1つ目のために書いたものは、2つ目で壊れます。2つ目を処理できるものは、3つ目の括弧でつまずきます。そして明日になれば、4つ目の言い回しが現れます。2つ前の節のくじ引きは、あなたに一貫性を約束してはいないからです。これが根本的な問題です。自然言語は表面上のばらつきがとてつもなく大きく、モデルには、同じ事実を2回同じように言い表す義務がありません。プログラムは、可能性を受け取ることはできません。プログラムに必要なのは契約、つまり出力が必ず収まる固定された形です。
標準的な契約はJSON(入れ子になったキーと値のデータのための、単純で普遍的なテキスト形式)で、その形はスキーマによって固定されます。スキーマとは、どのフィールドが存在し、それぞれがどんな型を持ち、どれが必須で、どんな値が許されるかを宣言したものです。抽出のタスクなら、擬似コードでは次のようになります(各ベンダーの正確な構文は異なります)。
{ name:     string,                       required
  total:    number,                       required
  currency: one of "USD" | "EUR" | "GBP",
  no other fields permitted }
この契約に収まる答えは、プログラムの残りの部分がすでに理解しているデータ構造に、そのままデシリアライズされます。フィールドはコードが期待する場所にあり、合計は数値で、請求書#1041についての丁寧な文が現れることはありません。
モデルをどうやって従わせるかは、最初に思うよりも重要です。保証には2つの等級があり、それらは似たように聞こえるからです。弱いほうの等級は、頼むことです。プロンプトで形式を指示し、多くの場合はAPIのフラグ(一般に「JSONモード」と呼ばれます)でそれを裏打ちします。このフラグは、出力が少なくともJSONとしてパースできることを保証します。パースできるというのは低い基準です。モデルはそれでも、必須のフィールドを省いたり、余計なフィールドを作り出したり、数値が入るべきところに文字列を入れたりできます。構文は保証されても、形は願望にすぎないのです。強いほうの等級が制約付きデコーディング(constrained decoding)で、それに必要な絵は、あなたはすでに持っています。思い出してください。どのトークンも、順位付きのリストからくじ引きで選ばれるのでした。制約付きデコーディングは、あなたのスキーマを、すべてのステップで働くフィルターにコンパイルし、くじを引く前に、スキーマに違反するトークンをリストから1つ残らず消します。スキーマが次は数値だと言っていれば、文字が当たることはありません。フィールドのリストが閉じていれば、作り出されたフィールドが始まることはありません。モデルは妥当な続きの中から自由に選び、妥当でない続きを出力することはできません。適合性は、プロンプトで依頼されるのではなく、仕組みの中で強制されるのです。プロバイダーはこれを「structured outputs」や「strict」なツールモードといった名前で提供しています。代価は、デコーディングのわずかなオーバーヘッドと、スキーマをどこまで凝ったものにできるかについてのいくつかの制限です。
1つの境界を、インクでくっきりと引いておきたいと思います。形についての保証は、真実については何も語りません。制約付きデコーディングが約束するのは、記入済みの用紙が返ってくることです。それが正直に記入されているかどうかは、まったく別の問題です。モデルが注文の合計額を知らなければ、スキーマはモデルに無知を白状させはしません。きちんと型の合った数値を作り出させるだけです。誤用されたスキーマは、捏造を減らすどころか、捏造を受け取りやすくします。だから検証は、いずれにしてもあなたのコードに残ります。値の範囲、フィールド間のルール、「この顧客IDは本当に存在するか」。スキーマは形式を取り締まり、内容の監査役はあなたのままです。
では同じ考え方を、アクションに向けてみましょう。関数呼び出し(function calling、ツール呼び出しとも呼びます)は、モデルが依頼してよい関数の集合を、あなたがプロンプトと一緒に記述するところから始まります。それぞれの関数には、名前、自然言語による説明、引数のスキーマがあります。モデルは何も実行しません。手を持たず、書くことしかできないのです。モデルにできるのは、アクションが役に立つと判断したときに、文章の代わりに構造化されたリクエストを出力することです。関数の名前を挙げ、スキーマに合う引数を添えた小さなオブジェクトです。そして、止まって待ちます。やりとりは次のように進みます(模式的に示します。通信形式はプロバイダーによって異なります)。
1. you   -> model : ユーザーの質問 + ツール定義の一覧
2. model -> you   : { call: "get_weather", arguments: { city: "Paris" } }
3. your code      : 本物の get_weather("Paris") を実行する
4. you   -> model : ここまでの会話 + { result: { temp_c: 18 } }
5. model -> you   : "パリはいま18度くらいです。"
                    (または別のツール呼び出し。このサイクルを繰り返す)
このやりとりの2つの性質は、強調しておく価値があります(図2.5は、これを2つのレーンとして示しています)。1つ目は権限の分担です。提案するのはモデルで、決めるのはあなたのコードです。第1章ではこの文を軽く使いましたが、いまやそれが文字どおりの意味だとわかるはずです。システムの副作用はすべてステップ3で、あなたが書いた普通のコードの中で起こります。そこでなら、ログに記録することも、テストすることも、制限することも、拒否することもできます。モデルの貢献は、願いを表すデータ構造1つに尽きます。2つ目は、このやりとりには少なくとも2回のモデル呼び出しがあり、初心者がつまずくのはその2回目だということです。典型的な最初のバグは、ツールを実行して、その生の結果をユーザーに渡してしまうことです。結果はモデルに返さなければなりません(ステップ4)。なぜそれを依頼したのか、次に何をすべきかを知っているのは、モデルだけだからです。(そしてステップ4のメッセージを組み立てるときは、APIが返すデータの塊をまるごと渡すのではなく、モデルに必要な少数のフィールドだけを返してください。結果は1バイト残らず机の上に載るのです。)
もう一方の側を具体的にするために、ツール定義を1つ示します(これも擬似コードです)。
name:        create_ticket
description: サポートチケットを起票する。人間による対応が
             必要な問題をユーザーが報告したときに使う。
arguments:   { title:    string,                        required
               severity: one of "low" | "med" | "high", required
body: string }この定義(名前、説明、引数のスキーマ)が、モデルがあなたのツールについて知ることのすべてです。そしてdescriptionフィールドこそ、私があなたに最もじっくり見てほしい部分です。初心者が過小評価するのが、まさにここだからです。create_ticketを呼び出すかどうか、どう呼び出すかの判断は、この定義だけをもとに下されます。参照できるソースコードも、ウィキも、尋ねられる同僚もありません。初日の朝を迎えた有能な新人に向けたAPIドキュメントのつもりで書いてください。そのツールが何をするのか、いつそれに手を伸ばすべきか、隣のツールのほうがよい選択になるのはいつか。モデルがツールを誤用したり、役に立ったはずのツールを無視したりしたとき、真っ先に疑うべきはモデルではなく説明です。ツールそのものの設計、つまりその数、粒度、エラーメッセージは、独自の章(第5章)を与えられるほどの技術です。
現実は異常系をきちんと試してきますから、それに備えてください。モデルは、検証に通らない引数を出力することも、存在しないツールの名前を挙げることも、1ターンで複数の呼び出しを行うこともあります。ハンドラーは、呼び出しが0個、1個、複数個のいずれでも対応できるようにしておくべきです。意外なほどうまくいくリカバリは、失敗をデータとしてモデルに返すことです。ツール結果として構造化されたエラーメッセージを返し(「未知のツール:create_tickets。使えるツールは…」)、モデルにそれを読ませて、次のターンで軌道を修正させるのです。こうしたリトライには厳格な予算で上限を設け、それを超えたら実行が目に見える形で失敗するようにしておきます。頑固な混乱が、あなたの負担でループしつづけることを許してはなりません。第18章では、この直感を1つの規律に育てます。
最後に、この節があなたに橋を引き渡す前に掲げておかなければならない注意があります。整形式であるというのは構文についての言明であり、安全であるというのは結果についての言明です。スキーマに完璧に適合したdelete_accountの呼び出しも、アカウントを削除することに変わりはありません。それを実行すべきかどうか(認可、確認、制限)は、ステップ3であなたのランタイムが下すべき判断です。第12章と第17章は、その判断をうまく下すための章です。この注意を掲げたところで、橋は架かりました。本書でこれから「ツール」と呼ぶものは、すべてまさにこの仕組みです。そしてエージェントとは、第1章で述べ、第3章でついに組み立てるとおり、この依頼・実行・返却のやりとりをループの中で回すものです。準備が1つだけ残っています。エンジンがどう失敗するかの、正直な地図です。
限界と失敗モード
注意深いエンジニアは、依存するどんな構成要素についても、2つのリストを持っています。それがうまくできることと、それがどう失敗するかです。この章はここまで、主に1つ目のリストでした。この節は2つ目のリストであり、その長さから想像される以上に重要です。本書の後半に出てくるガードレール、評価、検証のパターンはどれも、ここに挙げる項目のどれかがあるからこそ存在するのです。リストに入る前に、前置きを2つしておきます。これらは現世代のモデルの性質です。学習手法が改善されるにつれて和らぐものもあるでしょうが、本書の執筆時点で解決したものは1つもありません。あなたのモデルがどこまで来ているかは検証すべきことであり、本書はその方法を示しつづけます。そして、項目のほとんどは、エンジンが何であるかから直接導かれます。人間の選好によって形づくられたもっともらしさの機械には、特有の間違い方があります。それらはエンジニアリングには反応しますが、プロンプトの文言を厳しくすることにはめったに反応しません。
1つ目の項目には、原理のうえではすでに出会っています。ハルシネーションです。流暢で、具体的で、自信に満ちていて、しかも間違っている出力を指す、この分野の用語です。でっち上げの引用、存在しない関数、何も起きていない日のもっともらしい日付。仕組みはこの章の冒頭で述べました。モデルが事実を持っていないとき、仕組みは事実があるべき場所に、最ももっともらしく見える文字列を生み出します。もっともらしい文字列を生み出すことが、それのすることのすべてだからです。ハルシネーションを運用上危険なものにしているのは、その届き方です。捏造された答えは、正しい答えとまったく同じ確信に満ちた口調で届きます。口調は真実について何の情報も運びません。あなたにはその違いを聞き分けられませんし、どんな有用な意味においても、モデルにもできません。ある分析は、この点を居心地が悪くなるほど鋭く突いています。私たちはこうしたシステムを、採点によって当て推量へと追い込んできたのだ、というのです。学習もベンチマークも、不確かさを認めることより、自信のある回答を高く評価するからです。これは、多肢選択式の試験が、決して空欄を残さない生徒に報いるのとまったく同じです11 Adam Tauman Kalai et al., “Why Language Models Hallucinate”(2025年)、arXiv:2509.04664。この論文は、こうした捏造は学習中の「二値分類における誤りとして単純に生じる」ものであり、「言語モデルはよいテスト受験者になるように最適化されており、不確かなときに推測することはテストの成績を向上させる」ために残りつづける、と論じています。。さらに悪いことに、捏造は援軍を呼び寄せます。いったん誤った主張が実行記録に残ると、モデルは(いつものように、それより前のすべてを条件としながら)その上に一貫した詳細を積み上げていく傾向があります。このパターンはハルシネーションの雪だるま化(hallucination snowballing)として知られています12 Muru Zhang et al., “How Language Model Hallucinations Can Snowball”(2023年)、arXiv:2305.13534。誤った主張をするよう誘導されたモデルは、続けてそれを裏づける偽りの詳細を生成しました。その詳細は、別途尋ねられれば、モデル自身が偽りだと正しく見分けられるものでした。。
2つ目の項目は、あなたが何より手放したくない直感を打ち砕きます。能力はなめらかだ、という直感です。難しいことがこれほど得意なシステムなら、簡単なことは少なくとも同じくらい得意なはずだ、と。その反例には、この章ですでに小さな形で出会っています。本当に難しい問題を一息で解いたかと思えば、次の瞬間には英単語の文字を確実に数えることができないエンジンです。このパターンは一般化でき、印象的な名前を得ています。ギザギザのフロンティア(jagged frontier)です。事前登録制のフィールド実験(分析の内容を事前に固定しておき、都合のよい結果だけを拾い出せないようにした実験)で、数百人のコンサルタントが、モデルの支援がある場合とない場合とで、現実的なタスクに取り組みました。モデルの能力のフロンティアの内側にあるタスクでは、支援を受けたグループのほうが、目に見えて多くのタスクを、より速く、より高い品質評価で完了させました。フロンティアのすぐ外側に来るように意図的に選ばれた1つのタスクでは、支援を受けたグループが正解にたどり着く確率は、19ポイント低くなりました13 Fabrizio Dell’Acqua et al., “Navigating the Jagged Technological Frontier,” Harvard Business School Working Paper 24-013(2023年)。この事前登録された実験には758人のコンサルタントが参加しました。フロンティアの内側では、完了したタスクが12.2%多く、完了までの時間が25.1%短く、品質の評価が40%以上高いという効果があった一方、フロンティアの外側に来るよう設計されたタスクでは、正答率が19ポイント低くなりました。この用語はこの論文が作ったものです。。この結果には、2つの教訓が乗っています。フロンティアの縁は、あなたの立っている場所からは見えません。失敗したタスクは、より難しそうには見えませんでした。研究者たちは、まさに同程度に見えるという理由でそれを選んだのです。そして、隣での能力は、ここでの能力について何も証明しません。あなたのモデルがあなたのタスクをこなせるかどうかを知る唯一の確かな方法は、あなたのタスクであなたのモデルをテストすることです。この文は第16章で再び現れ、1つの規律へと育ちます。
3つ目は手短に。モデルは、どんな仕様書も許さないような形で、言い回しに敏感です。2つの句の順序を入れ替える、同義語に置き換える、リストの書式を変える。それだけで答えが変わりえます。あなたが同等だとみなす2つのプロンプトも、機械にとっては単に2つの異なるトークン列だからです。前の節でプロンプトを経験的な対象として扱うよう勧めたのは、仕組みの上ではこれが理由です。コードと同じようにテストし、上流で何かが変わってプロンプトに届く言葉が変わったら、テストし直すのです。
4つ目は迎合(sycophancy)、つまり、あなたが聞きたがっているように見えることを言おうとするモデルの偏りです。自分で実験してみてください。モデルが正しく答えられる事実についての質問をし、それから「それは違うと思います」と返します。心穏やかでいられないほどの頻度で、モデルは謝り、正しい答えを取り下げます。新しい証拠が示されたわけでも、モデルが証拠を求めたわけでもないのに、です。その足跡は、少なくとも部分的には事後学習にさかのぼります。モデルは人間の評価者が好む答えに向けて調整され、評価者はしばしば同意やお世辞を好み、モデルはその教訓をよく学んだのです14 Mrinank Sharma et al., “Towards Understanding Sycophancy in Language Models,” Anthropic(2023年。ICLR 2024で発表)。この研究は、複数のフロンティアモデルのアシスタントにわたる迎合的な振る舞いを記録し、その原因の一端を、同調的な応答を好む人間の選好判断にたどっています。。迎合が最も痛いのは、あなたがモデルに最も頼りたい場面、つまり作業のチェックです。「本当に?」は弱い検証です。モデルは、質問が差し出す枠組みを何であれ追認する傾向があるからです。疑わしげに押せば折れ、肯定的に尋ねれば支持します。本書があとで、本物の検証器は自己判断に勝ると主張し(第4章)、ジャッジとして使うモデルはそれ自体が検証されなければならないと主張するとき(第16章)、迎合はその理由の大きな部分を占めています。
5つ目は、正確な計算です。次トークン予測器は電卓を内蔵していません。そしてこの章の前のほうで、数の体系さえも恣意的なトークンの断片に溶けていくのを見ました。複数桁の算術、正確な数え上げ、正確な演繹の長い連鎖。こうしたものはぐらつきます。そして連鎖の途中でぐらついても、モデルは止まりません。間違った中間値から、流暢に続けていくのです。対策はアーキテクチャによるもので、安上がりです。正確な作業は正確なもの(電卓、データベース、実行されるコード)に回し、モデルには計算させるのではなくオーケストレーションさせるのです。第5章では、これを設計の原則にします。
6つ目は、第17章で本格的に扱うので、ここでは予告だけにとどめる項目です。モデルは指示とデータを区別のない1つの流れとして読み、両者を確実に見分けることができません。コンテキストを通過するだけのテキスト(取得したウェブページ、メール、ツール結果)でも、指示の形をしていれば、モデルの振る舞いを左右しうるのです。この攻撃の一群は、第1章で軽く名前を挙げたプロンプトインジェクションです。これがこのリストに入るのには、1つの理由があります。それがエンジンの性質であり、あなたがエージェントのコードを1行も書く前から存在するということです。(残りのいつもの容疑者である非決定性と古くなった知識は、この章の前のほうで扱いました。)
1つずつ見れば、これらは回避策のある厄介ごとにすぎません。これらが頭の中に永住権を得るに値するのは、つなげたときに何が起こるかのためです。第1章の羅針盤では、この計算を一度、主張として示しました。それを擁護するのはここであり、あとの章(第16章や第18章など)は、計算をやり直す代わりにここを振り返ることになります。エージェントは、互いに依存するステップの連鎖です。各モデル呼び出しは、それより前の呼び出しの結果をもとに推論します。各ステップが確率pで独立に成功し、タスクにnステップが必要だとしましょう。すると実行全体が成功する確率は、おおよそpnです。では、正直な数値を入れてみます。ステップごとの信頼性が95%というのは素晴らしく聞こえますし、デモでは実際に素晴らしいものです。20ステップのタスクでは、0.9520 ≈ 36%。少し悪い92%で30ステップなら、0.9230 ≈ 8%。ステップごとの数値ならボーナスがもらえたでしょうが、エンドツーエンドの数値は、決して賭けたくないコイン投げです。指数関数は交渉に応じない。図2.6は、この減衰を描いたものです。

しかも、このきれいな掛け算は楽観的なほうのバージョンです。ステップが独立に失敗すると仮定しているからです。実際には独立ではありません。エージェントの誤りは自分自身の実行記録に残り、そこで(この章全体の論理によって)それ以降のすべてを条件づけるコンテキストになります。ハルシネーションの雪だるま化は、このパターンを事実に当てはめたものでした。同じことがアクションについても成り立ちます。うまくいかなくなりはじめた実行は、その時点から先、部分的に間違った机の上で推論しており、そのステップごとの誤り率は、実行が長くなるにつれて上がっていきます。長いタスクを測定している研究者たちは、まさにこの特徴を報告しています。信頼性は、独立性から予測されるよりも速く、タスクの長さとともに減衰するのです15 自己条件づけの効果(モデル自身の以前の誤りがコンテキストに積み重なるにつれて、ステップごとの精度が低下すること)は、長期的な実行に関する研究で報告されています。例:Sinha et al., “The Illusion of Diminishing Returns: Measuring Long Horizon Execution in LLMs”(2025年)、arXiv:2509.09677。。混乱したエージェントは混乱したままで、放っておけば、ますます混乱していきます。
この計算は容赦ありませんが、同時に物事をはっきりさせてもくれます。レバーがどこにあるかを正確に教えてくれるのです。レバーは3つあります。1つ目はnを減らすことです。ステップを統合し、前もって計算できるものは前もって計算し、大量の機械的な作業はサイコロを振らない普通のコードに押し出します(第5章で、これがどこまで行けるかを示します)。2つ目は実効的なpを上げることです。各ステップで検証し、失敗したらリカバリすることで、誤りの代償を実行全体ではなく1回のリトライで済むようにします。その仕組みが第V部を占めます。3つ目は、実行が途中で死ぬ代償を下げることです。チェックポイントを置き、実行が失敗しても、ゼロからではなく最後の正常な状態から再開できるようにします(第18章)。できないのは、指数を無視して祈ることです。ステップごとの精度は天井であって、予報ではありません。
これでエンジンの地図はできあがりました。地図が約束できるのは、そこまでです。この1章で、あなたは次のものを集めました。テキストの続きを書き、計画を手元に取っておかない予測器。有限で、高くつき、呼び出しのたびに片付けられ、端が最もくっきりしている机。1トークンずつ書き、同じテキストを二度と約束しないくじ引き。すべてをテキストの中で行う誘導の規律。テキストを、チェック済みの実行可能なリクエストに変える橋。そして、筆頭の項目が指数である失敗のカタログ。そのどれにも算数を超える数学は必要ありませんでしたが、そのすべてが、すぐに荷重を支えるものになります。第II部はこのエンジン(才気にあふれ、忘れっぽく、自信過剰で、サイコロに動かされるエンジン)を受け取り、ループの中に置きます。